
Genie 4 開始研究預覽:可邊探索邊改寫場景,並生成聲音
Google DeepMind 將實時世界模擬交給少量可信測試者,加入原生音訊與 Gemini 引導。Project Genie 和開發者入口仍待開放,長時間一致性及物理準確性也未解決。
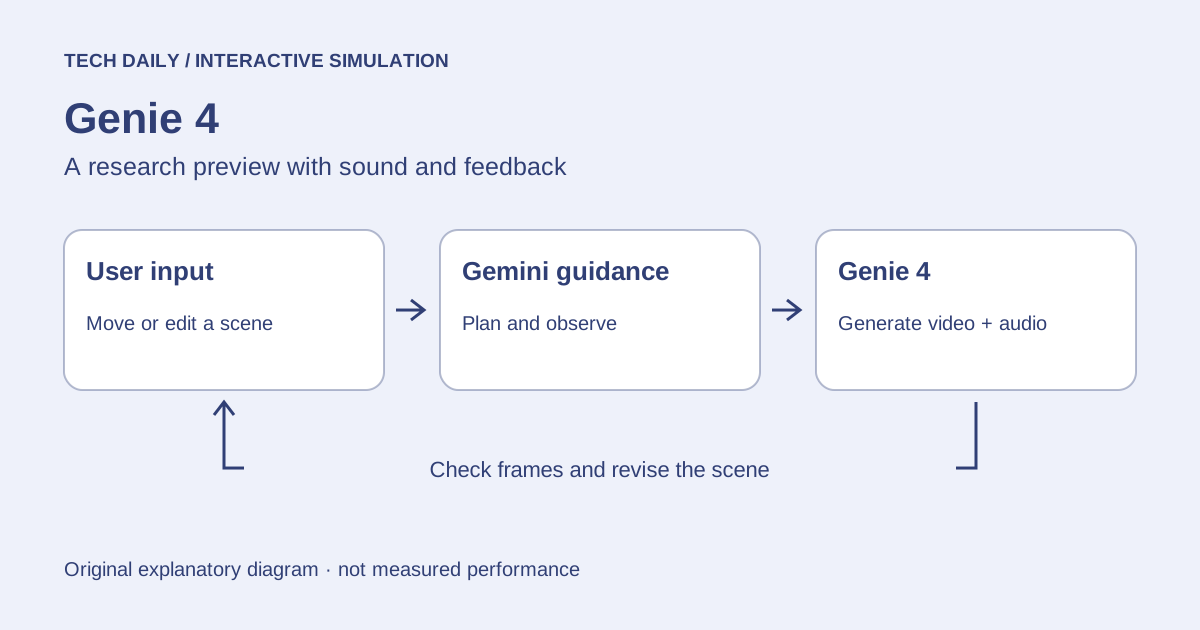
10 月 27 日,Google DeepMind 公佈 Genie 4,並開始向少量可信測試者提供研究預覽。它生成的是可以持續操作的場景:使用者移動視角或改變要求後,模型接著生成環境的反應。這次加入了與世界一同生成的聲音,也把 Gemini 放進持續觀察和引導場景的過程。
- 使用者提出目標或操作場景
- Gemini 拆解目標並觀察畫面
- Genie 4 生成後續畫面與聲音
- 繼續觀察、修正;長時間仍可能漂移
從看影片到在場景裡行動
普通影片生成通常交付一段片段,世界模型則要在使用者行動後繼續接住前面的狀態。Genie 4 支援鍵盤導航、攝像機控制,以及在模擬過程中用文字改變天氣、加入人物或調整場景。環境音、音樂和人物對話由模型同時生成,不只是事後新增的配樂。
官方說明,Gemini Omni 提供與外觀和行為有關的基礎能力,Gemini 3.8 Flash 則充當引導者:把目標拆成步驟,觀察輸出畫面,再檢查場景有沒有朝目標推進。本站將這一機制理解為帶反饋的生成過程;它有助於解釋為什麼模型能夠回應連續操作,但不能據此認定每一步都可靠。
機器人演示證明了什麼
DeepMind 還展示了 Gemini 4 Argon 配合 Genie 4 的研究實驗:圍繞模擬中的 Apptronik Apollo 機器人下跳棋,規劃步驟並生成相應場景。這個例子顯示了將推理模型與視覺模擬結合的方向,演示發生在生成環境裡,不能當作實體機器人已完成同一任務的證據。
對創作者而言,這類工具可能用於快速試驗鏡頭和互動想法;對機器人研究者而言,關鍵問題則是模擬中的規律能否足夠穩定、準確地對應現實。前一種用途可以容忍一定視覺誤差,後一種需要更嚴格的驗證。這是本站對應用條件的分析,並非本次釋出已經證明的訓練收益。
開放範圍和仍未解決的問題
截至本次公告,已提供的是可信測試者研究預覽。面向 Google AI Ultra 使用者的 Project Genie,以及 Gemini API 和 AI Studio 的早期合作伙伴入口,仍屬於後續計劃。Google 官方簡訊與獨立報道都區分了這兩個階段,因此不能將它寫成已經全面上線或開放模型權重。
DeepMind 承認,較長會話、複雜修改和場景導航仍可能使物體與細節漂移;物理互動、音訊準確性、可讀文字和空間一致性仍在研究中。官方影片是演示,不是本站獨立測試。影片和音訊會加入 SynthID 標記,但水印也不能替代對內容真實性和模擬精度的判斷。

留言
使用 GitHub 帳號參與討論,所有語言版本共用此留言區。
在 GitHub 查看討論查看舊留言(Disqus)